Como saber se o seu juiz (LLM-as-a-judge) acerta: as métricas por trás do eval
Accuracy, precision, recall, F1, support e kappa, cada uma respondendo a uma pergunta.
Na parte 3, terminamos com uma pergunta: se o LLM juiz também erra, como saber se dá para confiar nele?
A resposta curta é: comparando as decisões dele com as de uma pessoa. A resposta longa é este texto, porque “comparar” pode ser feito de vários jeitos, e alguns deles enganam.
Lembra do exemplo? Um juiz que aprova tudo concorda com a pessoa em 90% dos casos, se 90% das respostas forem boas. Parece ótimo, e ele não pegou nenhum erro. O problema não é o juiz, é o número que escolhemos olhar.
Neste texto, vamos ver as métricas mais usadas para avaliar um juiz. Sem fórmula assustadora: cada uma responde a uma pergunta diferente.
O exemplo
Voltamos ao assistente do app de delivery. O critério do juiz é o mesmo da parte 3: a resposta oferece uma solução concreta, como reenvio ou reembolso?
Uma pessoa leu 100 conversas e marcou cada resposta como boa ou ruim. Ela encontrou 90 boas e 10 ruins. Depois, o juiz avaliou as mesmas 100.
Um detalhe de vocabulário antes de seguir: nas métricas, o caso “positivo” é o que você quer encontrar. Aqui, queremos encontrar respostas ruins. Então “positivo” é a resposta ruim, e o juiz “acerta um positivo” quando reprova uma resposta que de fato é ruim. Parece invertido, mas é só isso: positivo é o que o juiz está procurando.
A tabela de acertos e erros
Toda decisão do juiz cai em uma de quatro situações:
- Reprovou e a resposta era ruim: acertou. São 7 casos.
- Reprovou, mas a resposta era boa: alarme falso. São 5 casos.
- Aprovou, mas a resposta era ruim: deixou passar. São 3 casos.
- Aprovou e a resposta era boa: acertou. São 85 casos.
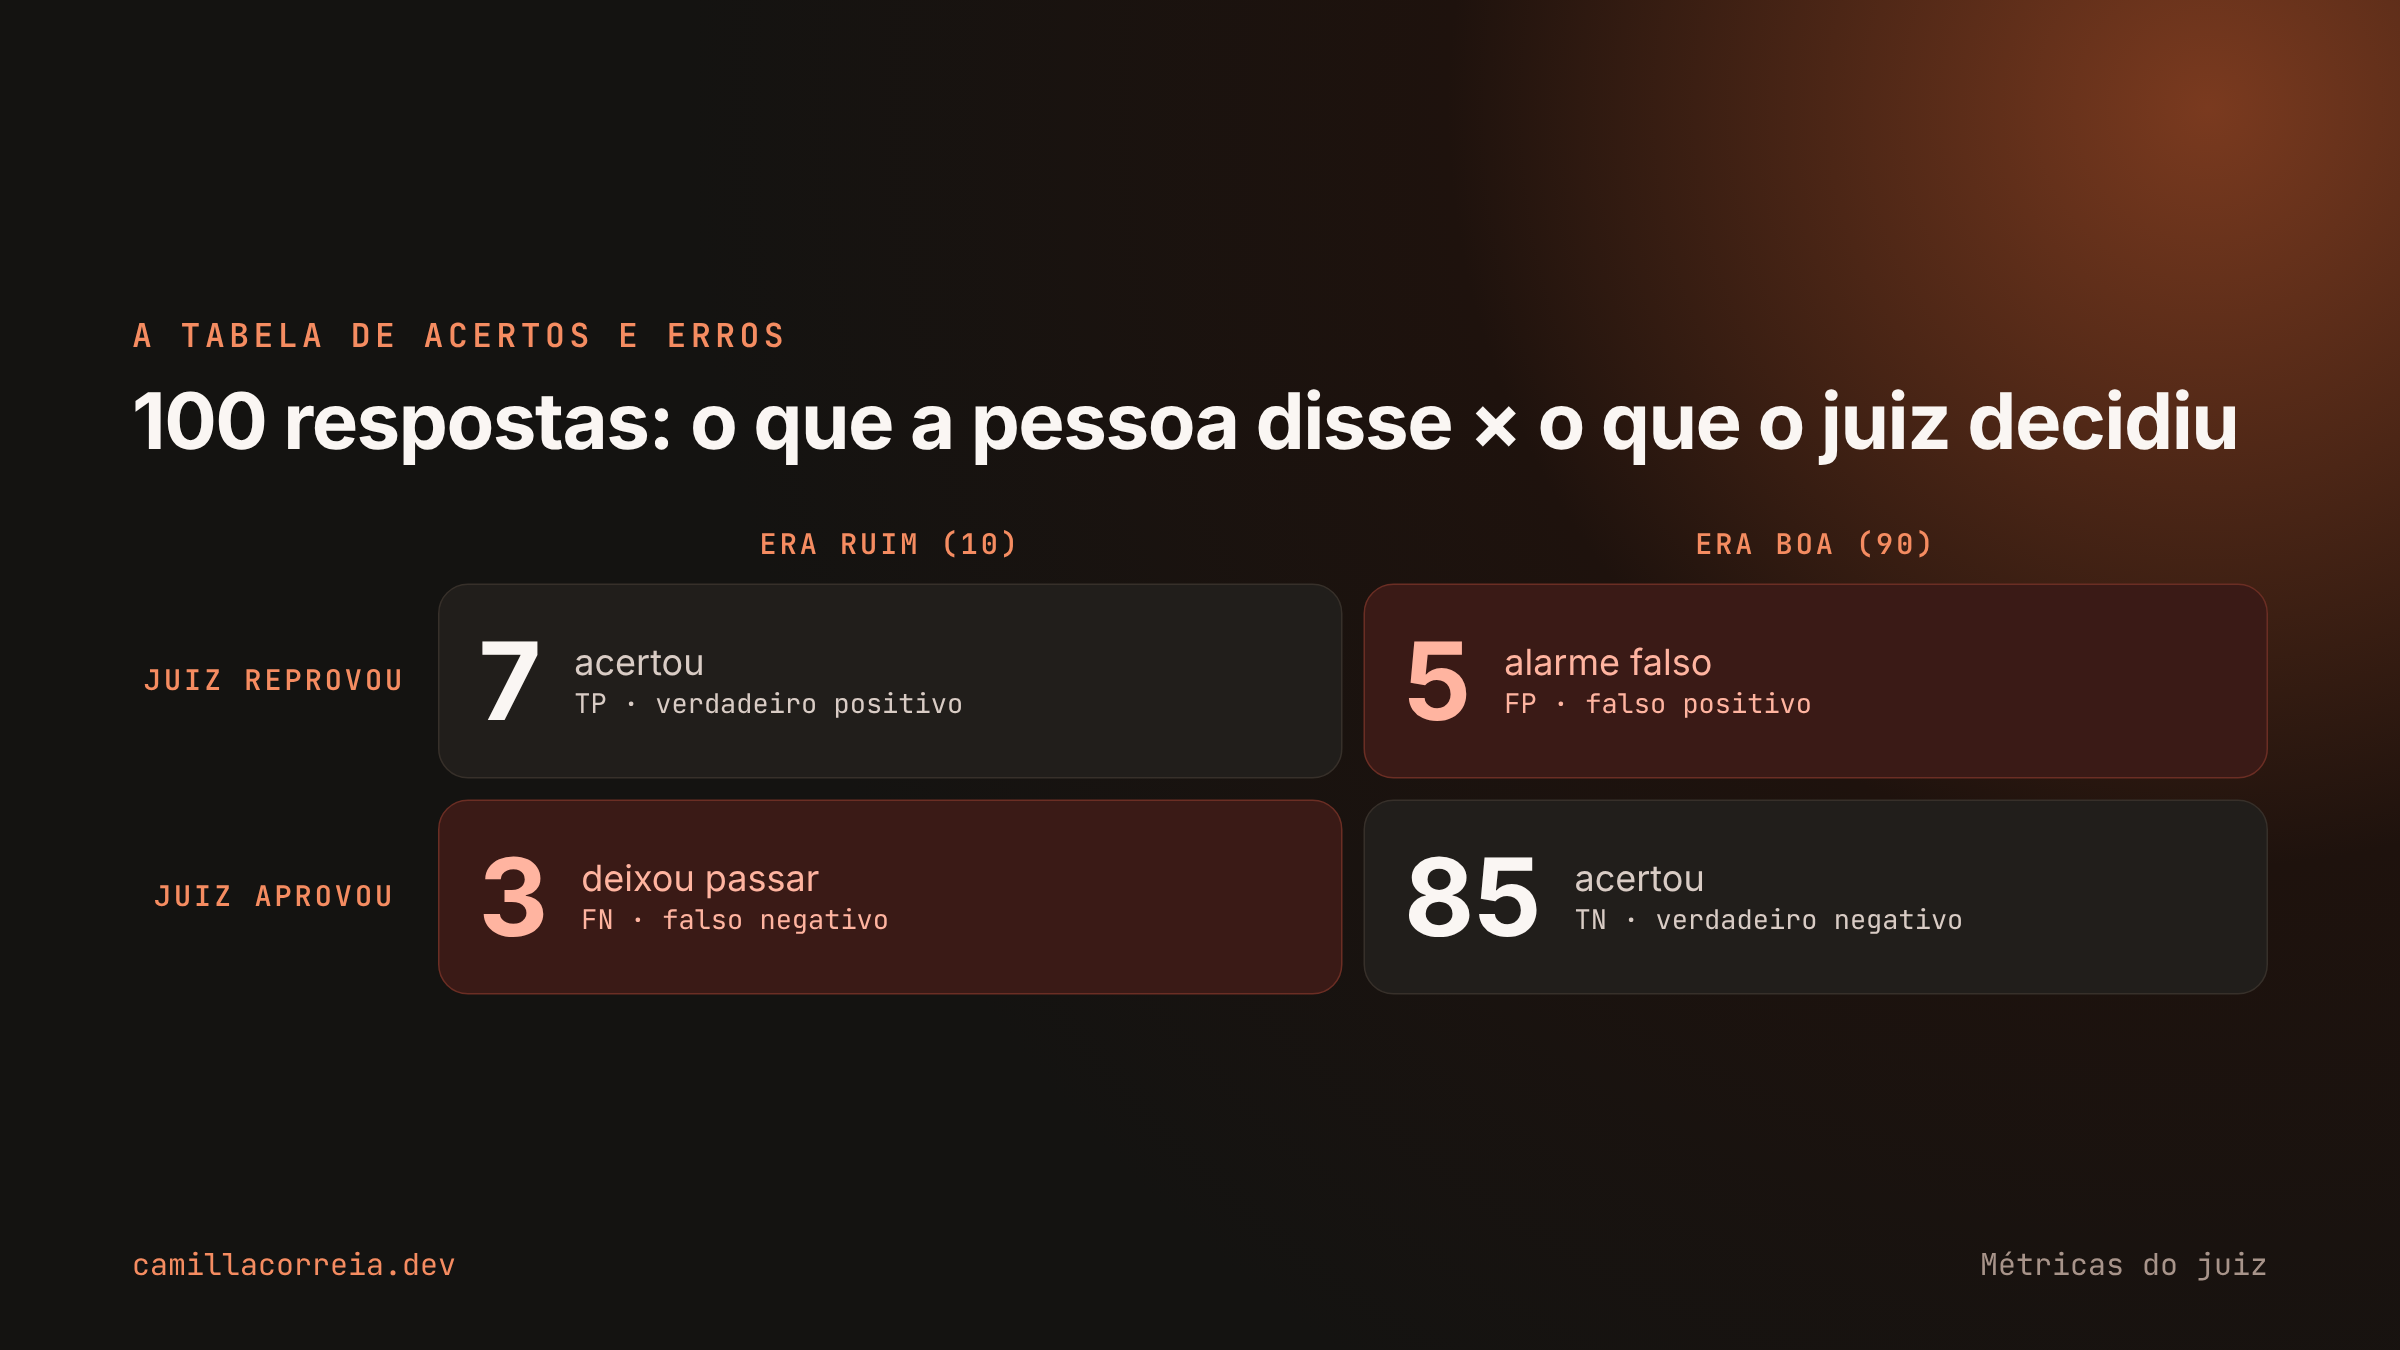
As caixas vermelhas são os erros do juiz.
Essa tabela tem um nome técnico, matriz de confusão, e todas as métricas a seguir saem dela. Os nomes em inglês que você vai encontrar por aí são:
- verdadeiro positivo (true positive, TP): reprovou e era ruim;
- falso positivo (false positive, FP): reprovou, mas era boa;
- falso negativo (false negative, FN): aprovou, mas era ruim;
- verdadeiro negativo (true negative, TN): aprovou e era boa.
Accuracy: quantas vezes o juiz concordou com a pessoa?
A conta: acertos divididos pelo total. (7 + 85) / 100 = 92%.
O que mostra: a concordância geral. É o número mais intuitivo, e por isso o mais usado.
Onde engana: quando um tipo de resposta é muito mais comum que o outro. Com 90 respostas boas, um juiz que aprova tudo tem 90% de accuracy sem pegar nenhum erro. O nosso juiz tem 92%, só 2 pontos a mais, e ele pegou 7 dos 10 erros. A accuracy quase não mostra essa diferença.
Recall: das respostas ruins, quantas o juiz pegou?
A conta: ruins que o juiz reprovou, divididas por todas as ruins. 7 / 10 = 70%.
O que mostra: quanto dos erros reais o juiz consegue encontrar. O juiz que aprova tudo tem recall de 0%, e aqui a armadilha dos 90% desaparece.
Quando importa mais: quando deixar passar um erro custa caro. Se a resposta ruim pode fazer um cliente perder dinheiro, você quer um recall alto, mesmo que o juiz dê alguns alarmes falsos.
Na parte 3, falamos de duas taxas: das respostas ruins, quantas o juiz reprovou, e das boas, quantas ele aprovou. A primeira é o recall. A segunda tem o nome de especificidade (ou true negative rate): 85 / 90 = 94%.
Precision: quando o juiz reprova, quantas vezes ele está certo?
A conta: reprovações corretas divididas por todas as reprovações. 7 / (7 + 5) = 58%.
O que mostra: se dá para confiar quando o juiz aponta um problema. Aqui, de cada 10 alertas, cerca de 4 são alarme falso.
Quando importa mais: quando cada alerta gera trabalho. Se toda reprovação vai para uma pessoa revisar, uma precision baixa significa gente gastando tempo com respostas que estavam boas.
Recall e precision costumam puxar para lados opostos. Um juiz mais rigoroso pega mais erros (recall sobe), mas reprova mais respostas boas (precision cai). Um juiz mais tolerante faz o contrário.
F1: o equilíbrio entre os dois
A ideia: o F1 junta precision e recall num número só. Mas, em vez da média simples, ele usa a média harmônica, que pune quem é ótimo numa ponta e péssimo na outra.
A conta: 2 × precision × recall / (precision + recall). Aqui, 2 × 58% × 70% / (58% + 70%) = 64%.
Por que não a média simples? Pense num juiz que reprova tudo. Ele pega todas as 10 respostas ruins, então o recall é de 100%. Mas das 100 reprovações, só 10 estavam certas, então a precision é de 10%.
- Média simples: (100% + 10%) / 2 = 55%. Parece um juiz razoável.
- F1: 2 × 100% × 10% / (100% + 10%) = 18%. Mostra que ele não serve.
A média simples deixa um número muito alto compensar um muito baixo. A média harmônica não: se uma das duas despenca, o F1 despenca junto. Quando as duas estão próximas, como no nosso juiz (58% e 70%), o F1 fica perto da média simples.
O que mostra: se o juiz consegue encontrar erros sem gerar alarme falso demais, ao mesmo tempo.
Onde engana: ele esconde qual dos dois está fraco. Um F1 de 64% pode vir de recall alto e precision baixa, ou o contrário, e essas situações pedem correções diferentes. Use o F1 para comparar versões do juiz, mas olhe precision e recall antes de decidir o que mudar.
Support: quantos casos sustentam esse número?
A conta: nenhuma, é só a contagem. Aqui, o support é 10 respostas ruins e 90 boas.
O que mostra: quanta evidência existe por trás de cada métrica. É a métrica mais ignorada e uma das mais importantes.
Por que importa: o nosso recall de 70% vem de 10 casos. Se o juiz tivesse pegado só mais um, o recall pularia para 80%. Com tão poucos exemplos, a diferença entre duas versões do juiz pode ser só sorte. Antes de comemorar uma melhora, confira se existem casos suficientes para ela significar alguma coisa.
Kappa de Cohen: concordância descontando o acaso
A ideia: se o juiz decidisse no chute, mas respeitando a proporção de reprovações dele, ele ainda concordaria com a pessoa muitas vezes, só por sorte. O kappa mede quanto da concordância vai além desse acaso.
A conta, de forma simples:
- O juiz concordou com a pessoa em 92% dos casos.
- Pelo acaso, com essas proporções de aprovação e reprovação, esperaríamos cerca de 80% de concordância.
- O kappa olha só para o que sobra entre o acaso e a concordância perfeita. Aqui, fica em 0,59.
Como ler: 1 é concordância perfeita, 0 é o mesmo que o acaso. Uma escala comum (Landis e Koch, 1977) chama 0,41 a 0,60 de concordância moderada e 0,61 a 0,80 de substancial. Ela é uma convenção, não uma regra, mas ajuda a ter referência.
O teste do juiz que aprova tudo: accuracy de 90% e kappa de 0. O kappa denuncia na hora que esse juiz não sabe nada além do que o acaso já daria.
Um uso a mais: o kappa também serve para comparar duas pessoas avaliando as mesmas respostas. Se nem elas concordam, o problema provavelmente está no critério, não no juiz.
Qual métrica olhar primeiro?
Depende de qual erro custa mais caro no seu produto:
- Deixar passar uma resposta ruim é grave? Olhe primeiro o recall.
- Cada alerta gera trabalho para alguém? Olhe a precision.
- Quer comparar versões do juiz com um número só? Use o F1 ou o kappa, mas abra os números antes de decidir.
- Sempre: confira o support. E desconfie de accuracy quando as respostas boas forem a grande maioria.
E uma regra que vale para todas: meça o juiz em casos que você não usou para ajustar o prompt dele. Se os exemplos do prompt também estão na medição, qualquer métrica vai parecer melhor do que é.
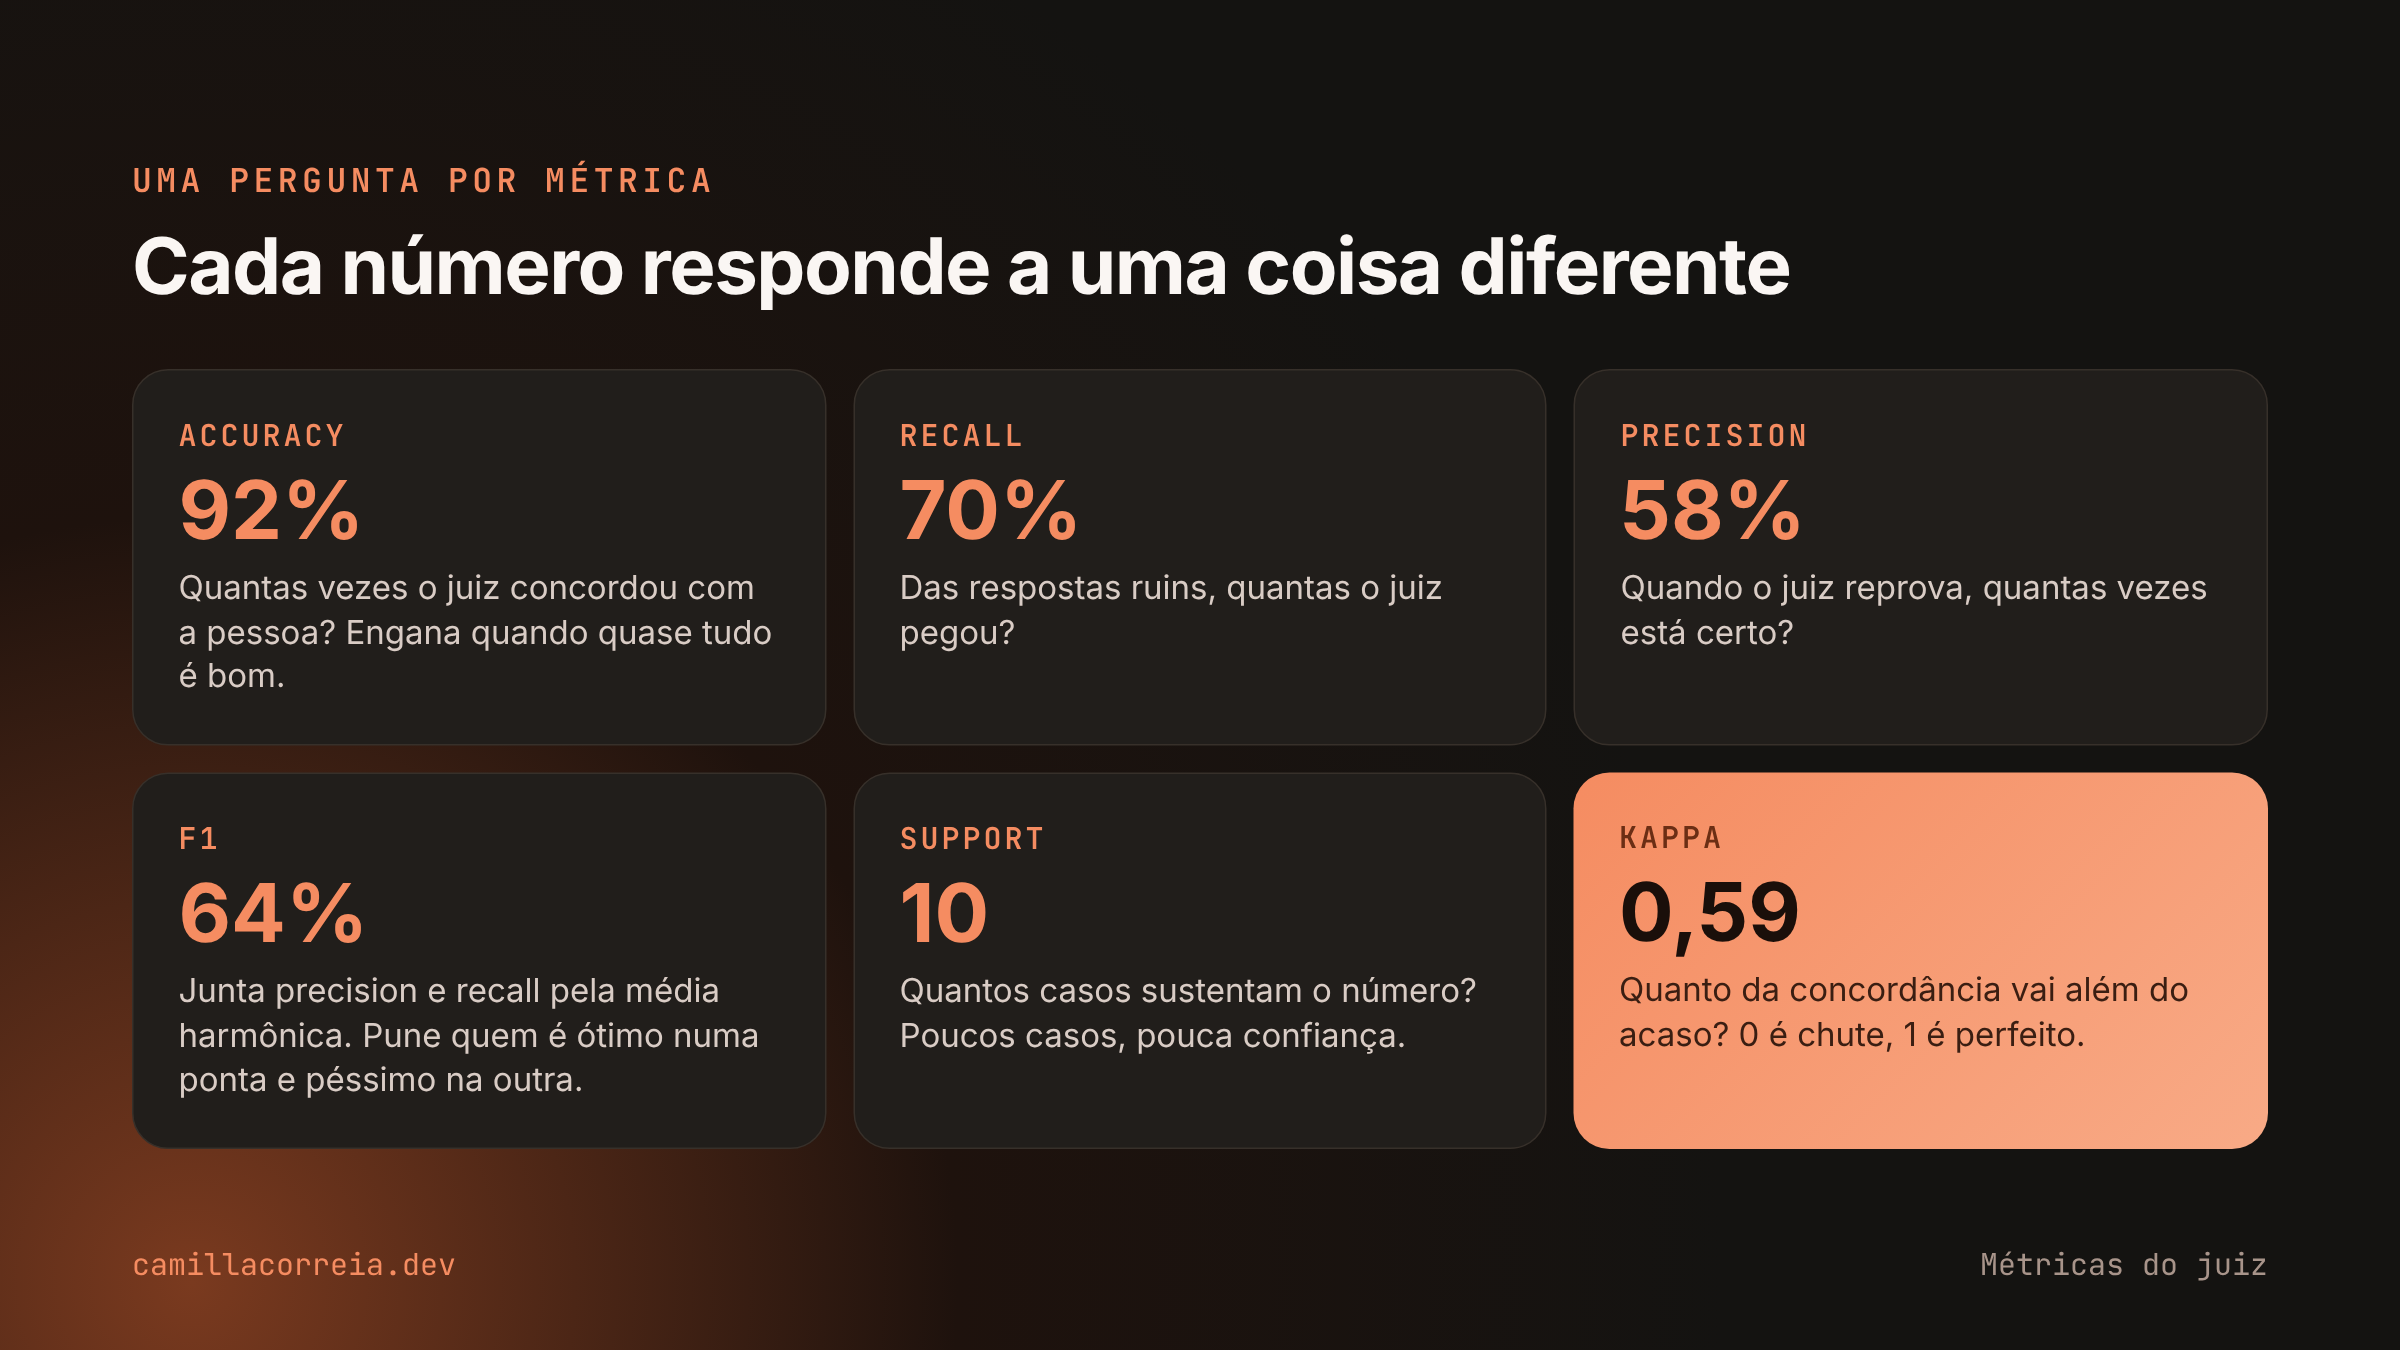
Cada número responde a uma pergunta diferente.
O que levar daqui
- Um juiz se avalia comparando as decisões dele com as de uma pessoa, e todas as métricas saem da tabela de acertos e erros.
- Accuracy é intuitiva, mas engana quando quase todas as respostas são boas.
- Recall: das respostas ruins, quantas o juiz pegou.
- Precision: quando o juiz reprova, quantas vezes está certo.
- F1 junta os dois pela média harmônica, que pune quem é ótimo numa ponta e péssimo na outra. Mas esconde qual dos dois está fraco.
- Support diz quantos casos sustentam cada número.
- Kappa mostra quanto da concordância vai além do acaso.
- A métrica certa depende de qual erro custa mais caro no seu produto.
Referências
- Hamel Husain e Shreya Shankar. AI Evals: Everything You Need to Know. hamel.dev, 2025. https://hamel.dev/blog/posts/evals-faq/
- Jacob Cohen. A Coefficient of Agreement for Nominal Scales. Educational and Psychological Measurement, 1960.
- J. Richard Landis e Gary G. Koch. The Measurement of Observer Agreement for Categorical Data. Biometrics, 1977.
Também publicado no Medium.