O que é eval? Como saber se o seu produto de IA está funcionando?
Eval é o processo de verificar se um sistema de IA faz o que deveria fazer. Por que avaliar IA é diferente de testar software, o problema dos erros silenciosos e como começar.
Colocar uma IA dentro de um produto nunca foi tão fácil. Em poucas horas dá para ligar um modelo de linguagem a uma interface de chat, escrever um prompt e ter algo que parece funcionar.
A pergunta difícil vem depois, como você sabe que funciona de verdade? Não só nos cinco exemplos que você testou, mas com centenas de pessoas escrevendo do jeito delas, todos os dias.
É para responder a essa pergunta que existem os evals.
O que é eval
Eval (de evaluation, avaliação) é o processo de verificar se um sistema de IA faz o que deveria fazer.
Dito assim, parece só outro nome para “teste”. Em parte é. A diferença é que, em produtos de IA, “o que deveria fazer” raramente é uma resposta única e exata. Por isso, avaliar IA virou uma disciplina própria, com métodos, vocabulário e ferramentas específicos.
Um detalhe muuito importante, eval não é um teste, uma nota nem um dashboard. É o processo inteiro de medir o comportamento do sistema e usar esse resultado para melhorá-lo.
Por que testar IA é diferente de testar software
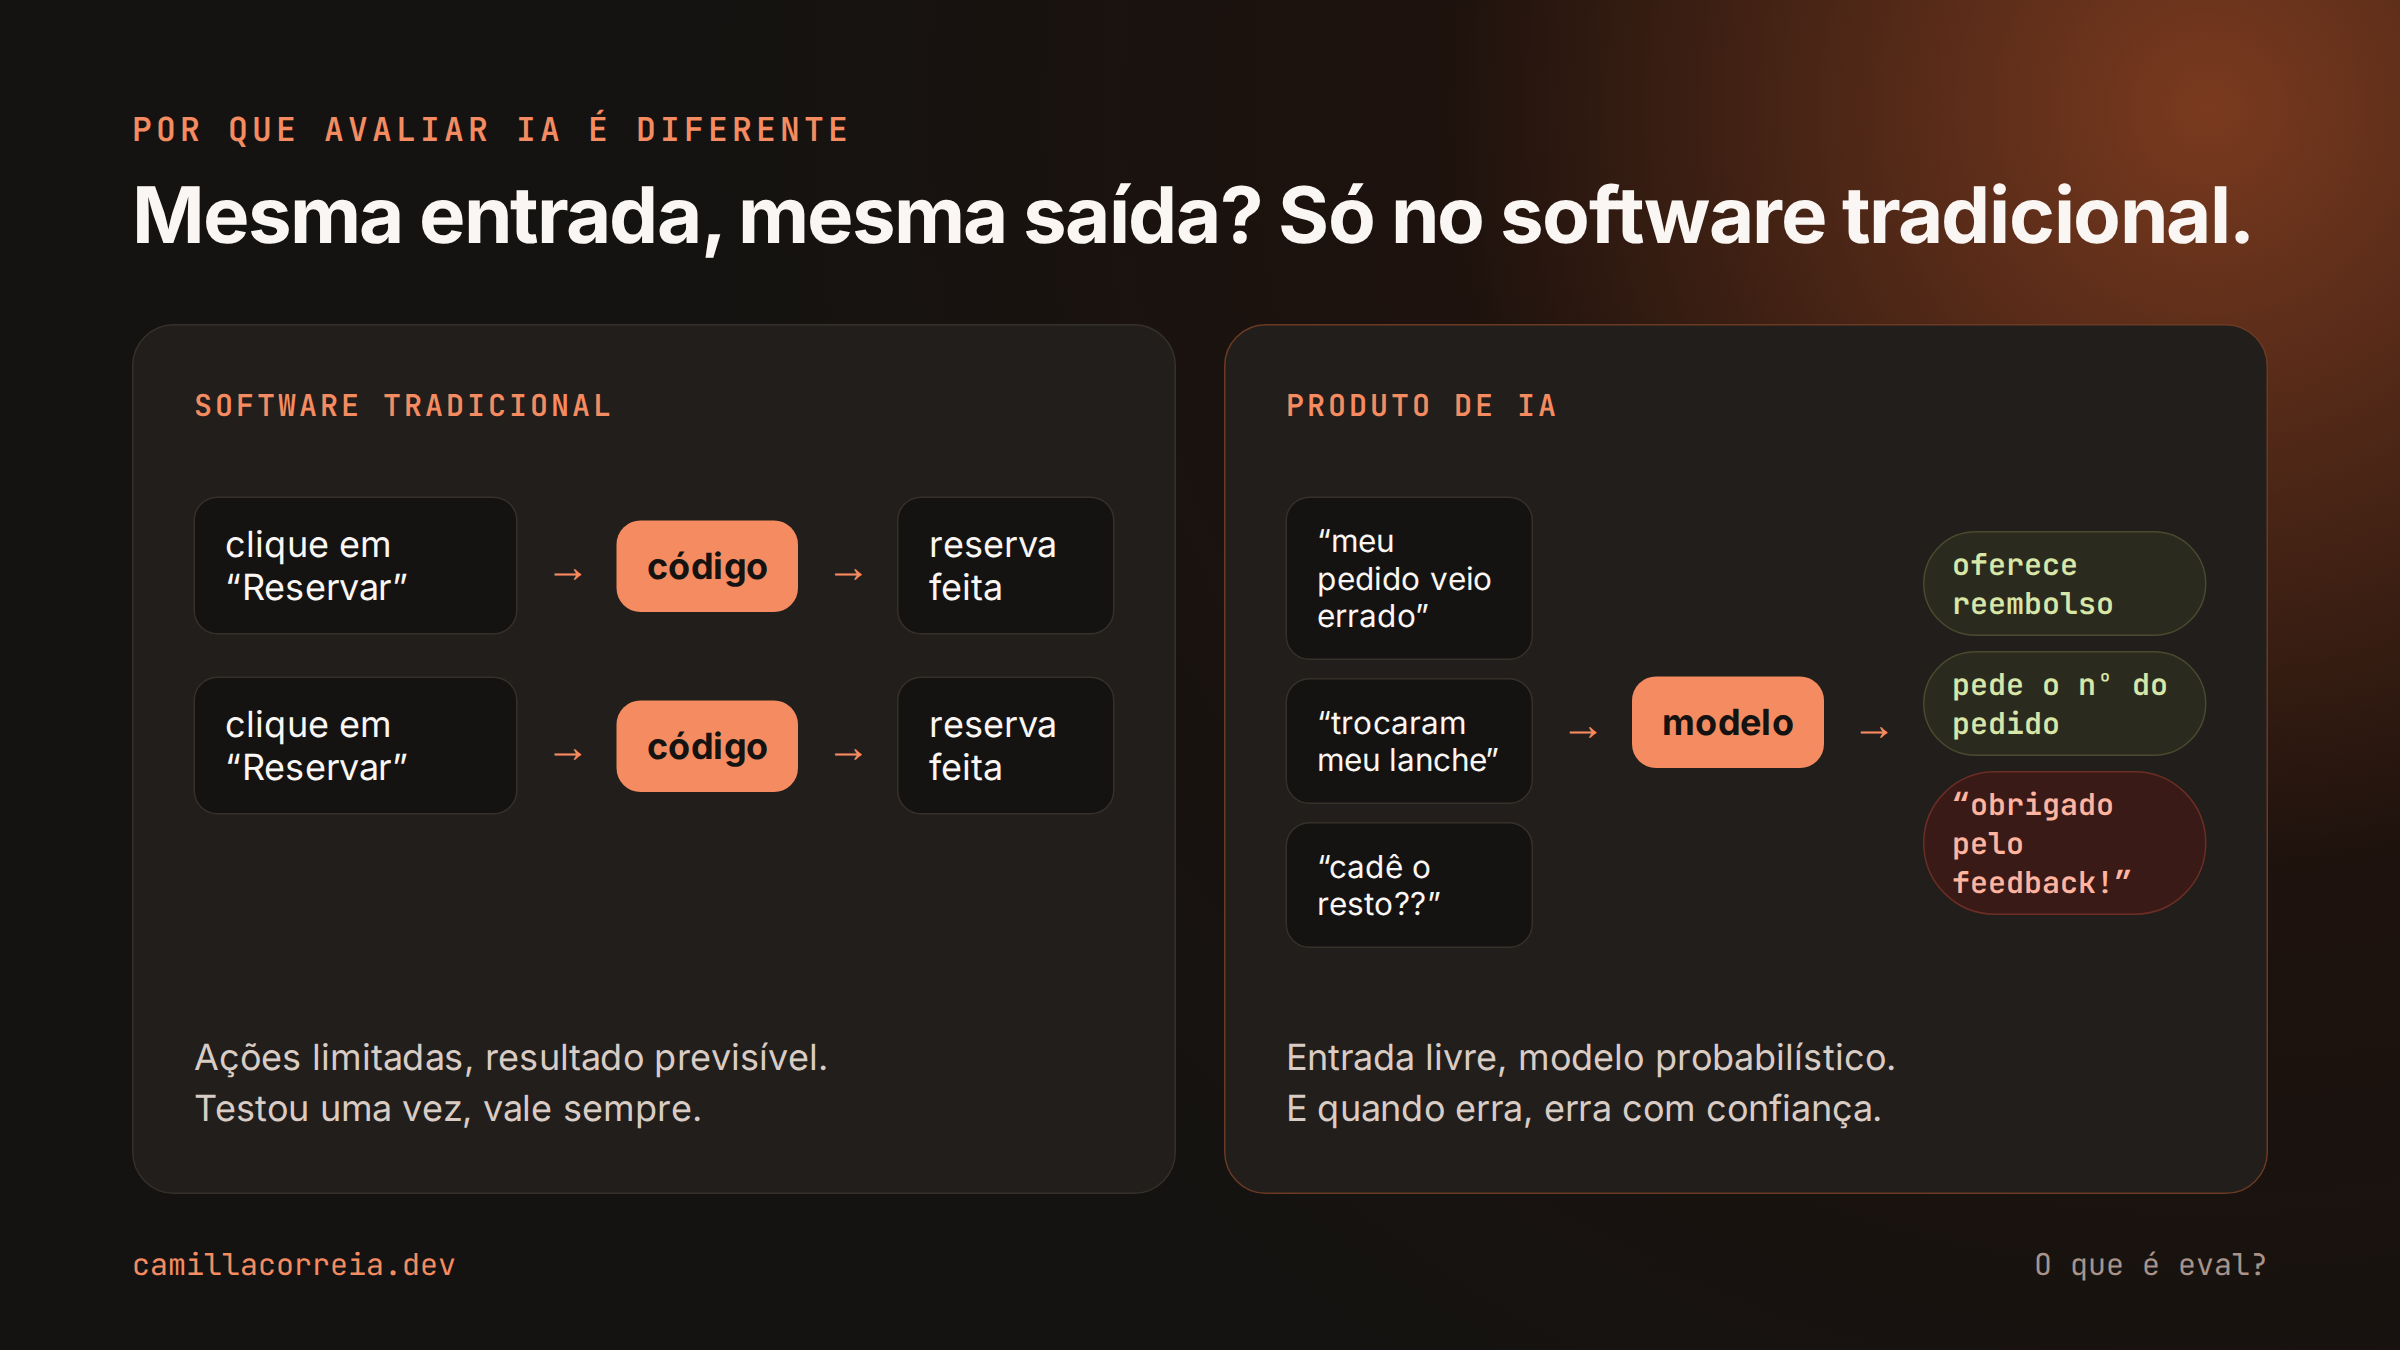
Pense num site de reservas de hotel. Você escolhe datas num calendário, clica em menus, aperta um botão. As ações possíveis são limitadas, o resultado é previsível e o código por trás é determinístico: a mesma entrada sempre gera a mesma saída. Se um teste passou antes do lançamento, ele tende a continuar passando em produção.
Agora pense num assistente de IA:
- A entrada é livre. O usuário escreve em linguagem natural, do jeito que quiser. Não dá para prever todas as formas de perguntar a mesma coisa.
- O processo é probabilístico. A mesma pergunta, ou uma levemente reformulada, pode gerar respostas diferentes.
- A saída não é única. Muitas respostas diferentes podem estar certas, e muitas que parecem certas estão erradas.
Isso quebra a premissa central dos testes tradicionais: “testei uma vez, vale sempre”.
O problema dos erros silenciosos
Quando um software tradicional falha, ele costuma falhar de forma barulhenta: aparece uma exceção, uma tela de erro, um alerta.
Quando a IA falha, ela geralmente não avisa. Ela entrega uma resposta confiante, bem escrita e errada. Não existe stack trace para uma resposta ruim. Muitas vezes você só descobre o problema pela reação do usuário, quando ele já foi embora insatisfeito.
Sem um processo de avaliação, esses erros passam despercebidos.
A ideia central: comparar três coisas
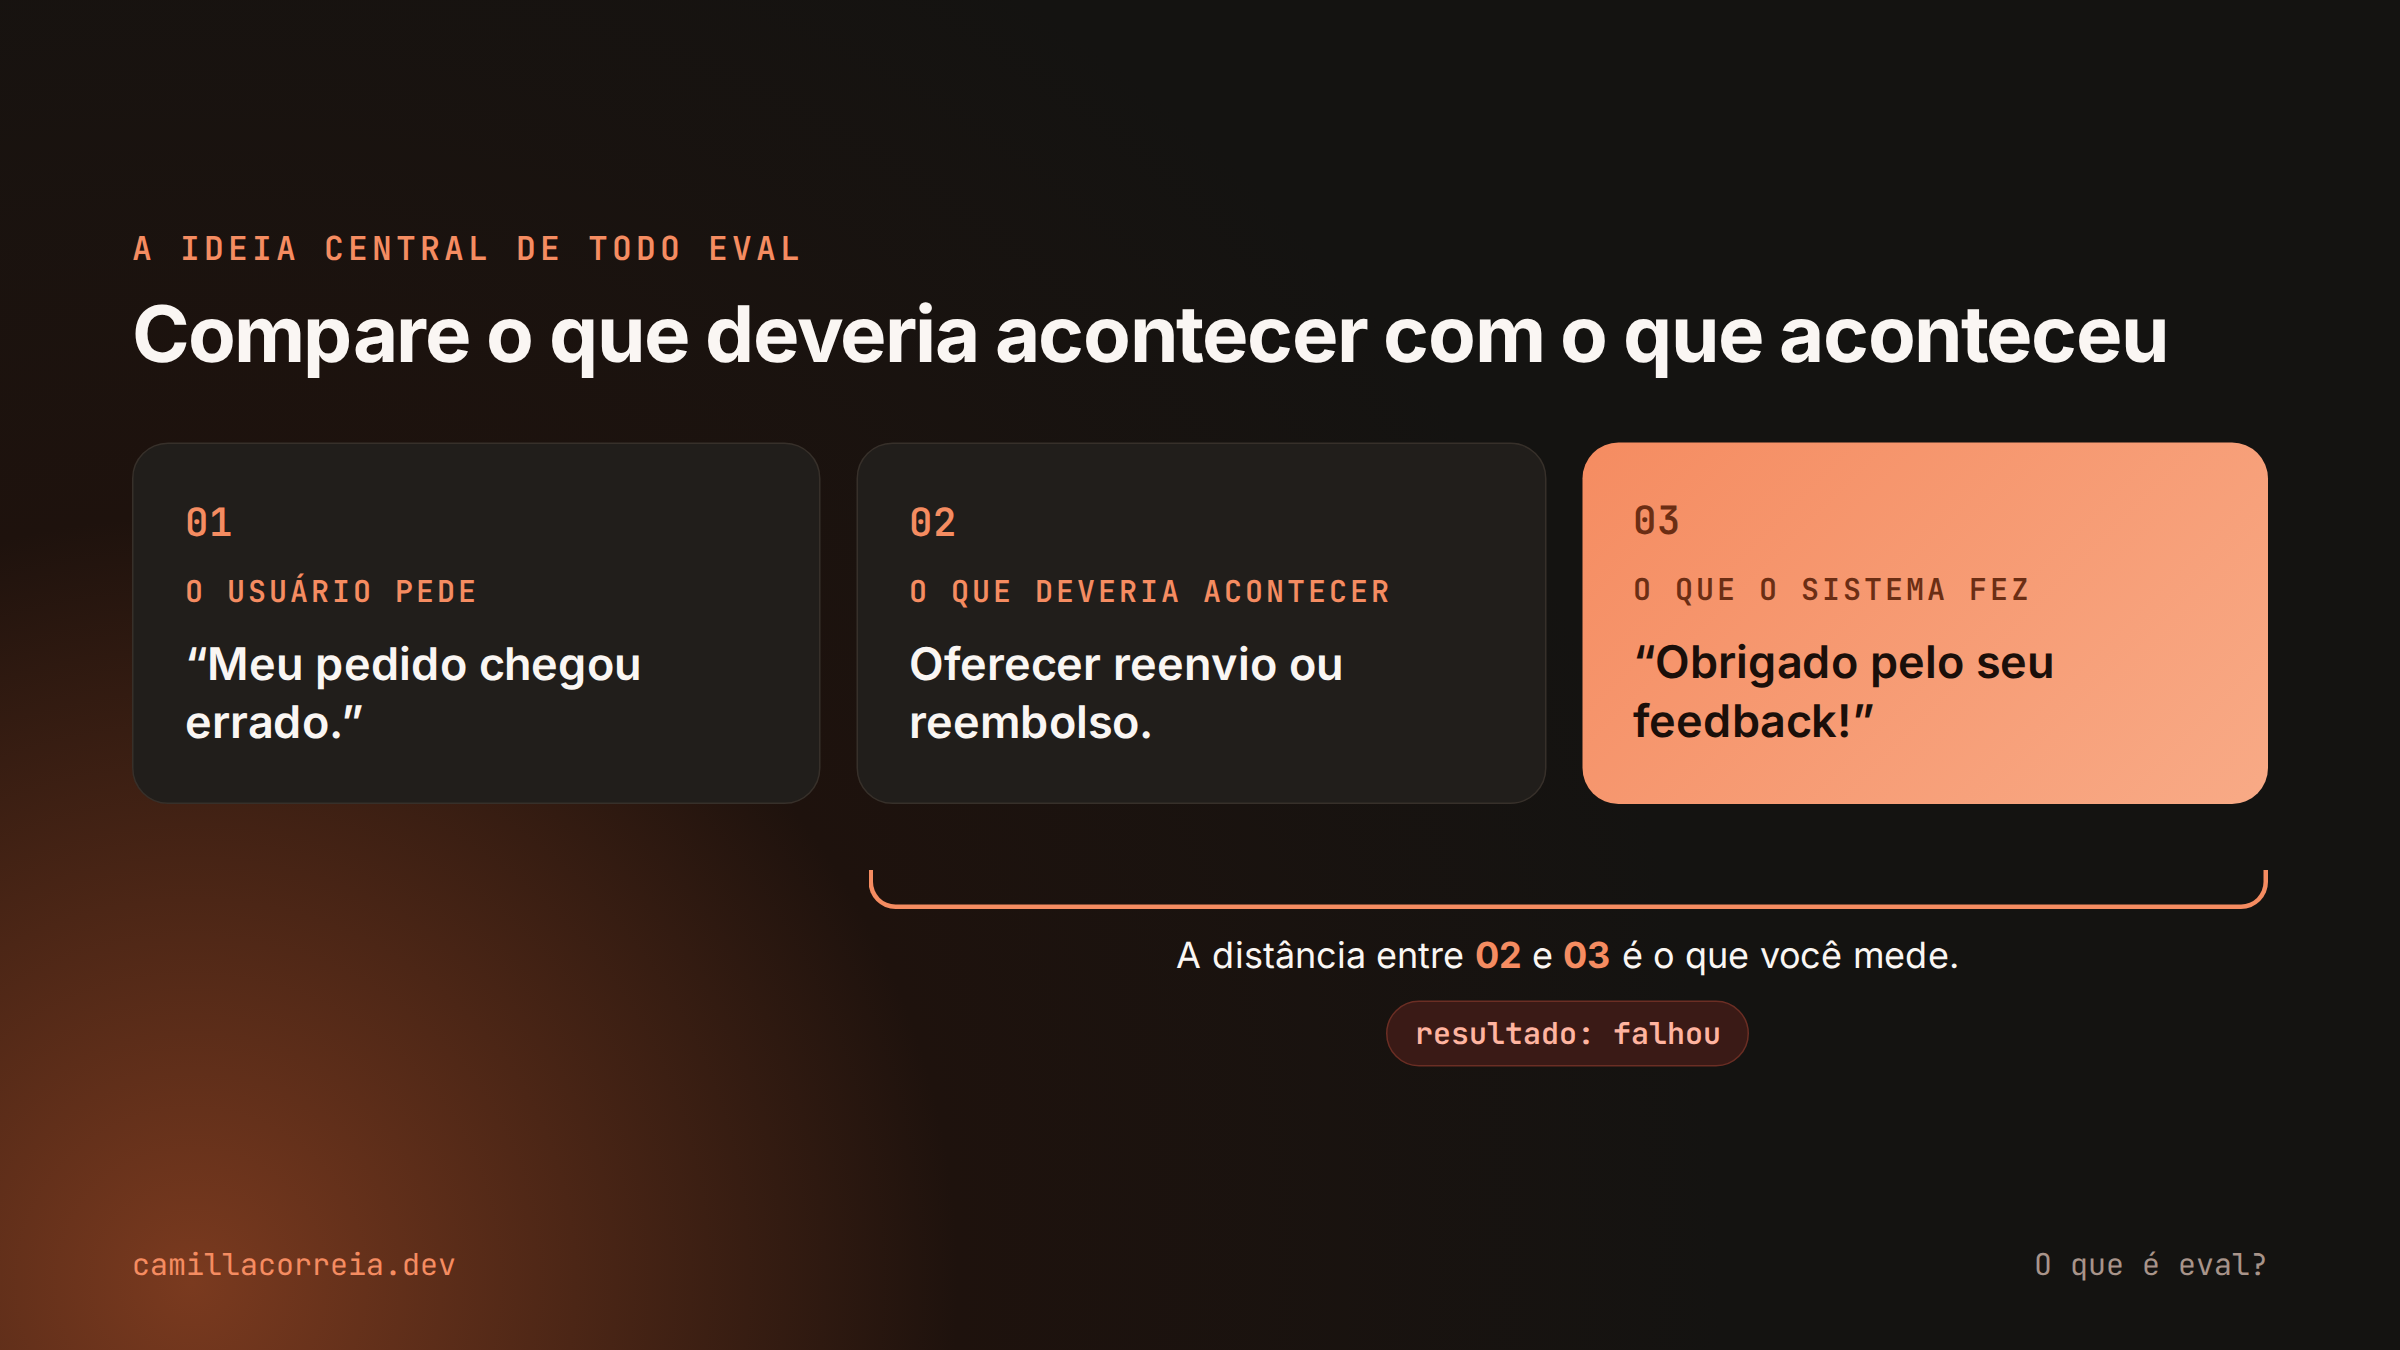
Todo eval, do mais simples ao mais sofisticado, começa comparando três coisas:
- O que o usuário pede (a entrada)
- O que deveria acontecer (o comportamento esperado)
- O que o sistema fez (o comportamento real)
A distância entre o item 2 e o item 3 é exatamente o que você quer medir.
Um exemplo. Imagine o assistente de um app de delivery:
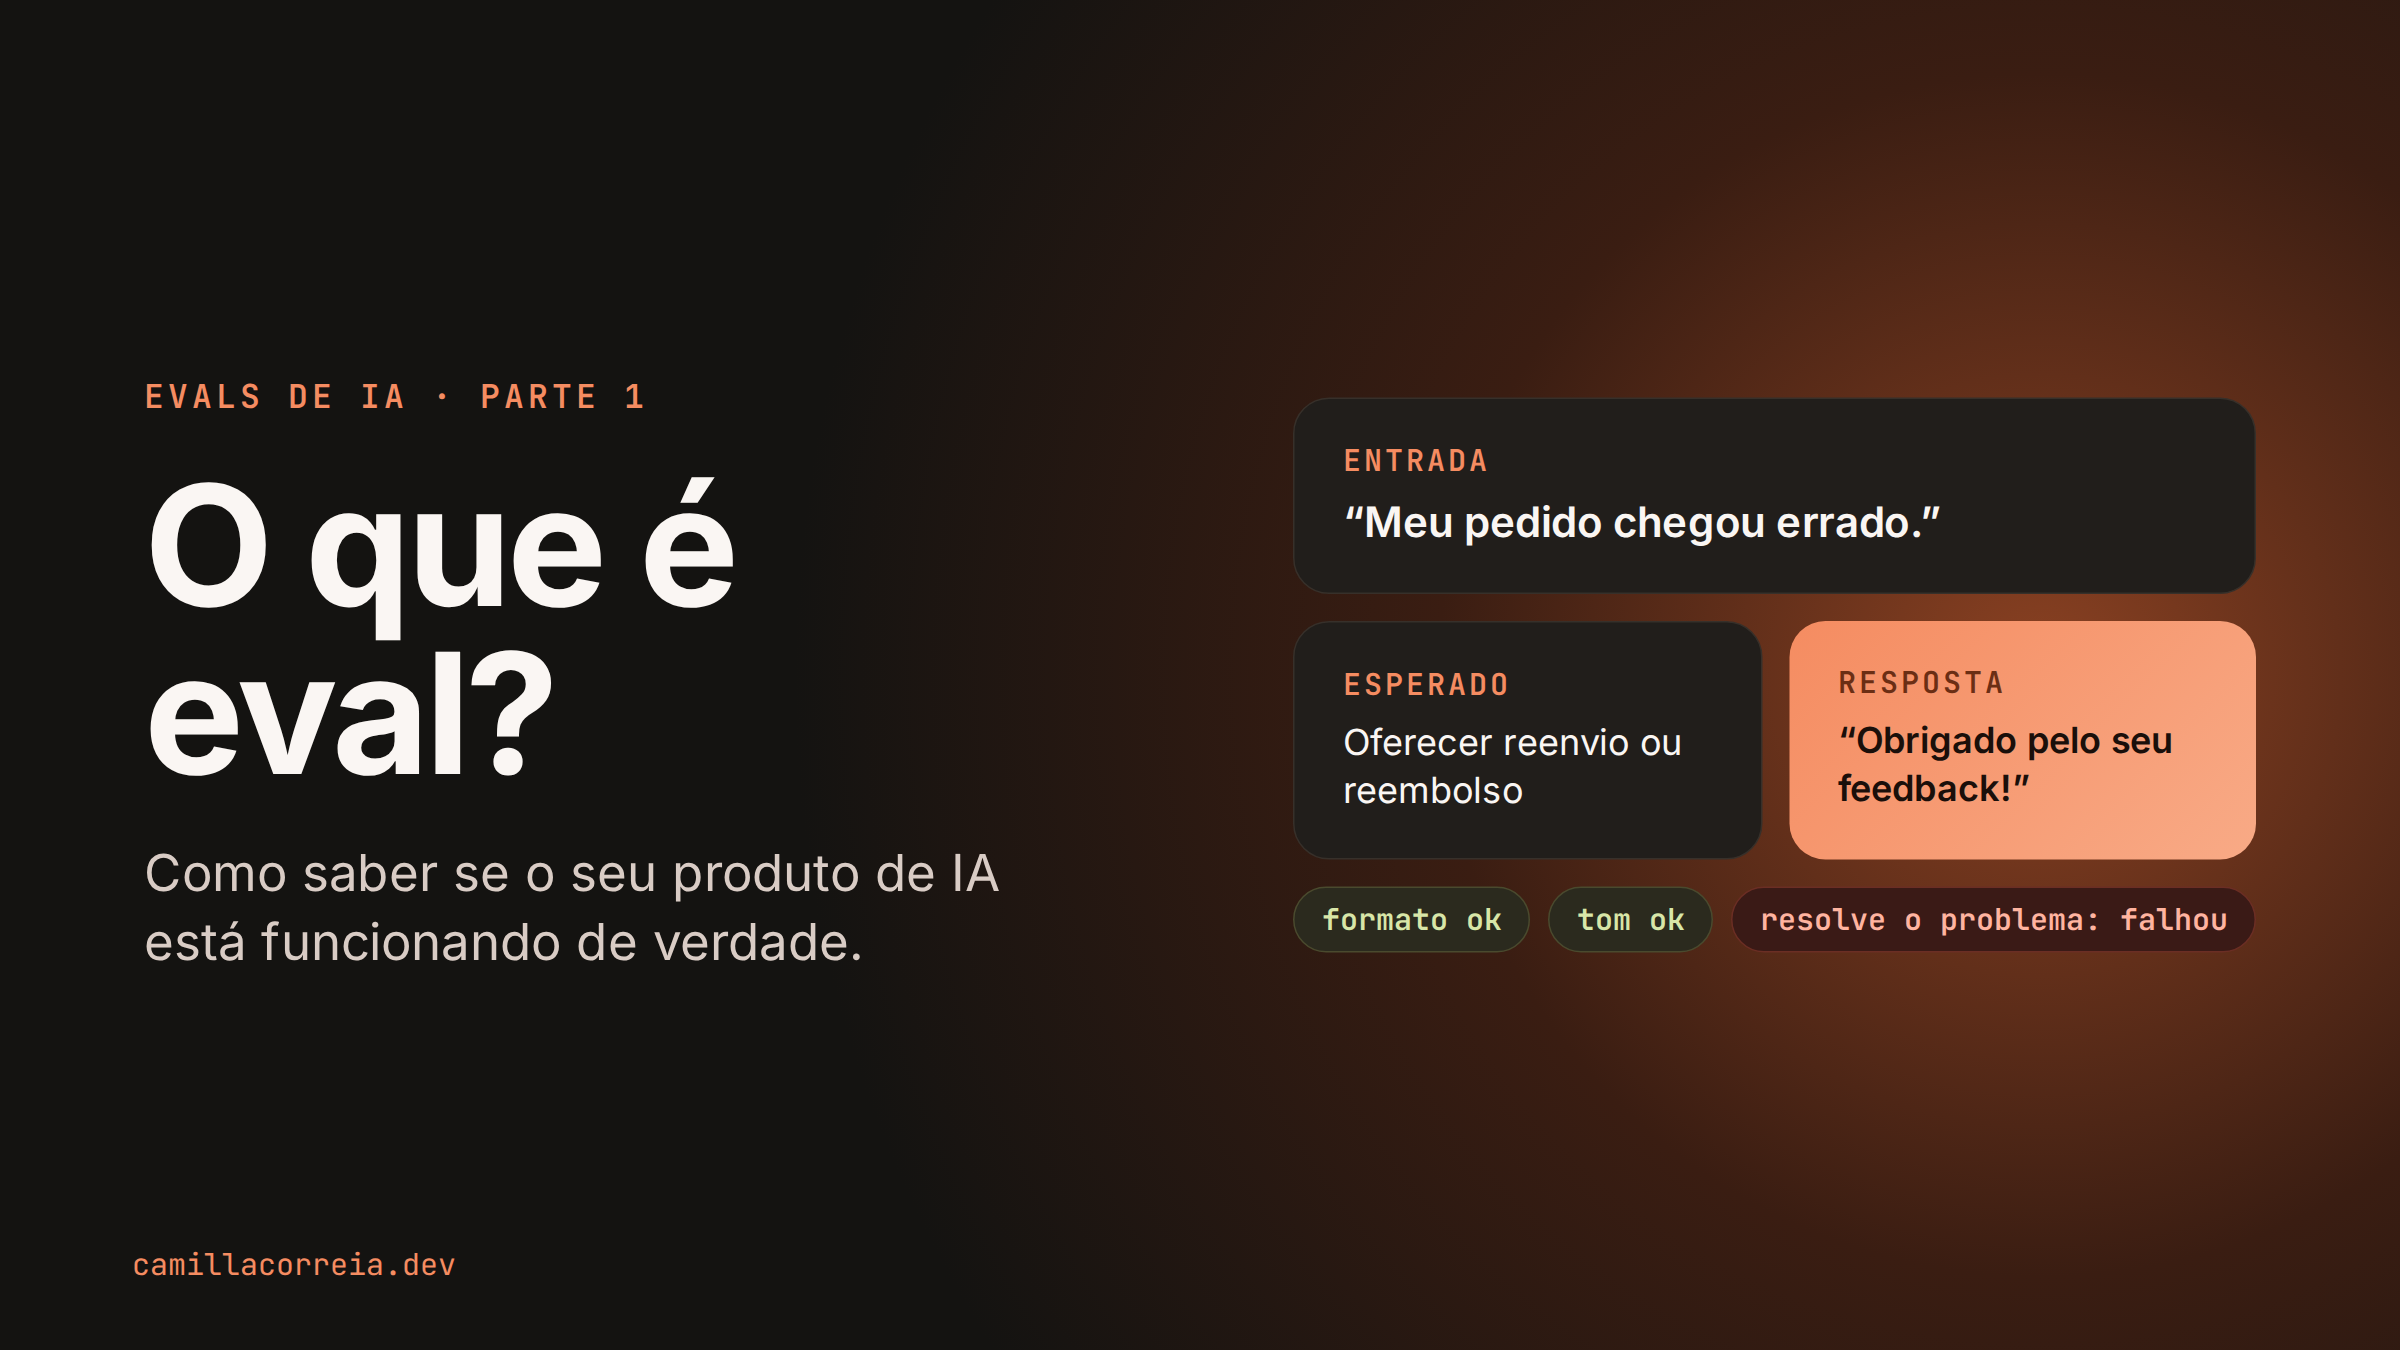
Usuário pede: Meu pedido chegou errado
Deveria: Oferecer reenvio ou reembolso
O sistema fez: Obrigado pelo seu feedback!
Resultado: Falhou
A resposta do sistema é educada e bem escrita. Ainda assim, não resolve o problema do usuário. Um teste que só verificasse “a resposta foi gerada sem erro” deixaria isso passar.
Montar uma pequena tabela como essa, com exemplos reais ou realistas do seu produto, já é o primeiro passo de um eval.
Quem faz a comparação?
Existem três formas principais de comparar o esperado com o real:
1. Avaliação humana. Uma pessoa ler a resposta e julga se está boa. É a forma mais confiável e é ela que define o que “bom” significa no seu produto. O problema é que não escala porque ninguém consegue revisar cada resposta em produção.
2. Checagens por código. Regras automáticas e objetivas, como, a resposta veio no formato certo? Os campos obrigatórios estão lá? Apareceu alguma palavra proibida? São rápidas e baratas, mas não entendem linguagem nem contexto.
3. LLM como juiz. Outro modelo de linguagem recebe a pergunta, a resposta e uma lista de critérios escritos por você, e decide se a resposta passa ou não. Ele consegue avaliar coisas subjetivas, como tom ou utilidade, mas também precisa ser avaliado. Antes de confiar no juiz, você compara as decisões dele com as de pessoas.
Na prática, as três formas se complementam. A avaliação humana define o padrão. Código e juiz automatizam esse padrão para rodar em volume.
Eval não é uma etapa, é um ciclo
Um erro comum é tratar eval como uma checagem feita uma única vez, antes do lançamento. Não funciona assim (experiência própria), porque o que você imagina sobre os usuários nunca é igual ao que eles fazem de verdade.
O processo se parece mais com um ciclo:
- Imagine como os usuários vão usar o sistema.
- Crie casos de teste com base nisso e avalie.
- Observe o uso real em produção.
- Ajuste os testes e o próprio sistema com o que aprendeu.
E recomeça. Cada volta deixa seus testes mais parecidos com a realidade e o produto mais confiável.
Por que isso importa
Sem evals, mudar um prompt ou trocar de modelo vira um jogo de adivinhação. Você conserta um problema, cria outro e não percebe. As decisões ficam baseadas em impressão (“parece que melhorou”).
Com evals, você passa a ter evidência. Sabe o que melhorou, o que piorou e onde o sistema ainda falha. É isso que separa um protótipo que impressiona numa demonstração de um produto em que as pessoas podem confiar.
Resumo
- Eval é o processo de verificar se um sistema de IA faz o que deveria fazer.
- Produtos de IA são imprevisíveis: entrada livre, modelo probabilístico e várias respostas possíveis.
- A IA erra em silêncio, com respostas confiantes e erradas.
- Todo eval compara o pedido, o esperado e o que o sistema fez.
- A comparação pode ser feita por pessoas, código ou outro modelo.
- Eval é um ciclo contínuo, não uma etapa antes do lançamento.
Referências
- Anthropic. Demystifying evals for AI agents. https://www.anthropic.com/engineering/demystifying-evals-for-ai-agents
- Teresa Torres (Product Talk). AI Evals: A Hands-On Guide for Product Teams. https://www.producttalk.org/ai-evals/
- Julien Riel. Evals: How to Test Systems That Don’t Have Right Answers. https://julien-riel.com/en/articles/evals/
- Evidently AI. LLM evaluation: a beginner’s guide. https://www.evidentlyai.com/llm-guide/llm-evaluation
- Aman Khan (Lenny’s Newsletter). Beyond vibe checks: A PM’s complete guide to evals. https://www.lennysnewsletter.com/p/beyond-vibe-checks-a-pms-complete
- Hamel Husain. AI Evals: Everything You Need to Know. https://hamel.dev/blog/posts/evals-faq/
- Shreya Shankar e Hamel Husain. Evals for AI Engineers: Systematically Measuring and Improving AI Applications. O’Reilly. https://www.oreilly.com/library/view/evals-for-ai/9798341660717/
E você, como sabe hoje se a IA do seu produto está funcionando?
Também publicado no Medium.