“Eval” virou uma palavra sobrecarregada
Benchmark, juiz, teste A/B e dashboard não são a mesma coisa.
Em algum momento, alguém na reunião diz: “precisamos de evals”.
Todo mundo concorda. E cada pessoa sai da sala pensando numa coisa diferente. Uma imagina um benchmark. Outra pensa em usar um LLM para dar nota às respostas. Alguém já está desenhando um teste A/B, e outra pessoa quer um dashboard.
Ninguém está errado: tudo isso faz parte da avaliação de IA. O problema é tratar tudo como se fosse a mesma coisa. Cada peça responde a uma pergunta diferente, e quando a gente confunde as peças, acaba medindo a coisa errada e tirando conclusões que os números não sustentam.
Neste texto, separo as quatro peças que mais aparecem quando alguém fala “eval”, e alguns outros nomes que você vai ouvir pelo caminho.
Primeiro: avaliação é um processo
Antes das peças, vale fixar uma ideia da parte 1: avaliação é o processo inteiro de verificar se um sistema de IA faz o que deveria fazer e usar esse resultado para melhorá-lo.
Não é um teste, uma nota ou um dashboard. Esses são instrumentos dentro do processo. A pergunta certa nunca é “a gente tem evals?”, e sim “o que queremos saber, e qual instrumento responde isso?”.
1. Benchmark
O que é: um conjunto padronizado de testes usado para comparar modelos. Os resultados costumam aparecer em rankings públicos, os famosos leaderboards.
Que pergunta responde: qual modelo vai melhor em tarefas gerais, como raciocínio, programação ou conhecimento geral?
O que não diz: se o seu produto funciona. O benchmark mede o modelo em condições padronizadas. O seu produto tem regras de negócio, ferramentas, base de conhecimento e usuários próprios, e nada disso aparece no ranking.
Quando usar: para filtrar quais modelos valem a pena testar. Não para decidir sozinho.
2. LLM como juiz
O que é: um modelo de linguagem que recebe a pergunta, a resposta do sistema e uma lista de critérios escritos por você, e decide se a resposta passa ou não.
Que pergunta responde: esta resposta segue os critérios que definimos?
O que não diz: se os critérios estão certos, nem se o juiz está acertando. O juiz é um instrumento de medição, e todo instrumento precisa ser calibrado. Antes de confiar nele, você compara as decisões dele com as de uma pessoa.
Quando usar: para avaliar em volume aspectos subjetivos, como tom, utilidade ou se a resposta resolveu o problema, que regras de código não conseguem checar.
3. Teste A/B
O que é: duas versões do produto rodando ao mesmo tempo, cada uma para uma parte dos usuários reais.
Que pergunta responde: qual versão gera mais resultado? Mais conversão, mais retenção, mais satisfação.
O que não diz: por que uma versão ganhou. E tem um detalhe importante: só acontece depois de lançar. Se a versão nova tiver um erro grave, os usuários do teste vão encontrá-lo.
Quando usar: para confirmar o impacto de uma mudança já avaliada antes, não como primeira linha de defesa.
4. Dashboard
O que é: métricas acompanhadas ao longo do tempo com o sistema em produção. Por exemplo, taxa de respostas com feedback negativo, tempo de resposta e custo por conversa.
Que pergunta responde: algo mudou?
O que não diz: o que mudou nem por quê. Um dashboard mostra que a taxa de reclamações subiu na terça. Para entender o motivo, alguém precisa ir até as conversas e ler.
Quando usar: para perceber cedo que algo saiu do esperado e saber onde investigar.
Outros nomes que você vai ouvir
Além das quatro peças principais, alguns termos aparecem misturados com “eval” com frequência:
- Dataset de referência (golden dataset): o conjunto de casos de teste com a resposta esperada para cada um. Muita gente chama esse arquivo de “o eval”, mas ele é a matéria-prima.
- Traces / observabilidade: o registro detalhado do que o sistema fez em cada interação: o que recebeu, que ferramentas chamou e o que respondeu. Não avalia nada sozinho, mas sem ele não há o que avaliar.
- Guardrail: uma barreira que bloqueia ou corrige uma resposta em tempo real, antes de chegar ao usuário. A diferença é sutil e importante: o eval mede, o guardrail impede.
- Red teaming: tentar quebrar o sistema de propósito, com perguntas maliciosas, ambíguas ou fora do esperado. É uma forma de avaliação focada em segurança e abuso.
Como as peças se encaixam
Uma forma simples de organizar tudo é separar o que acontece antes e depois de lançar:
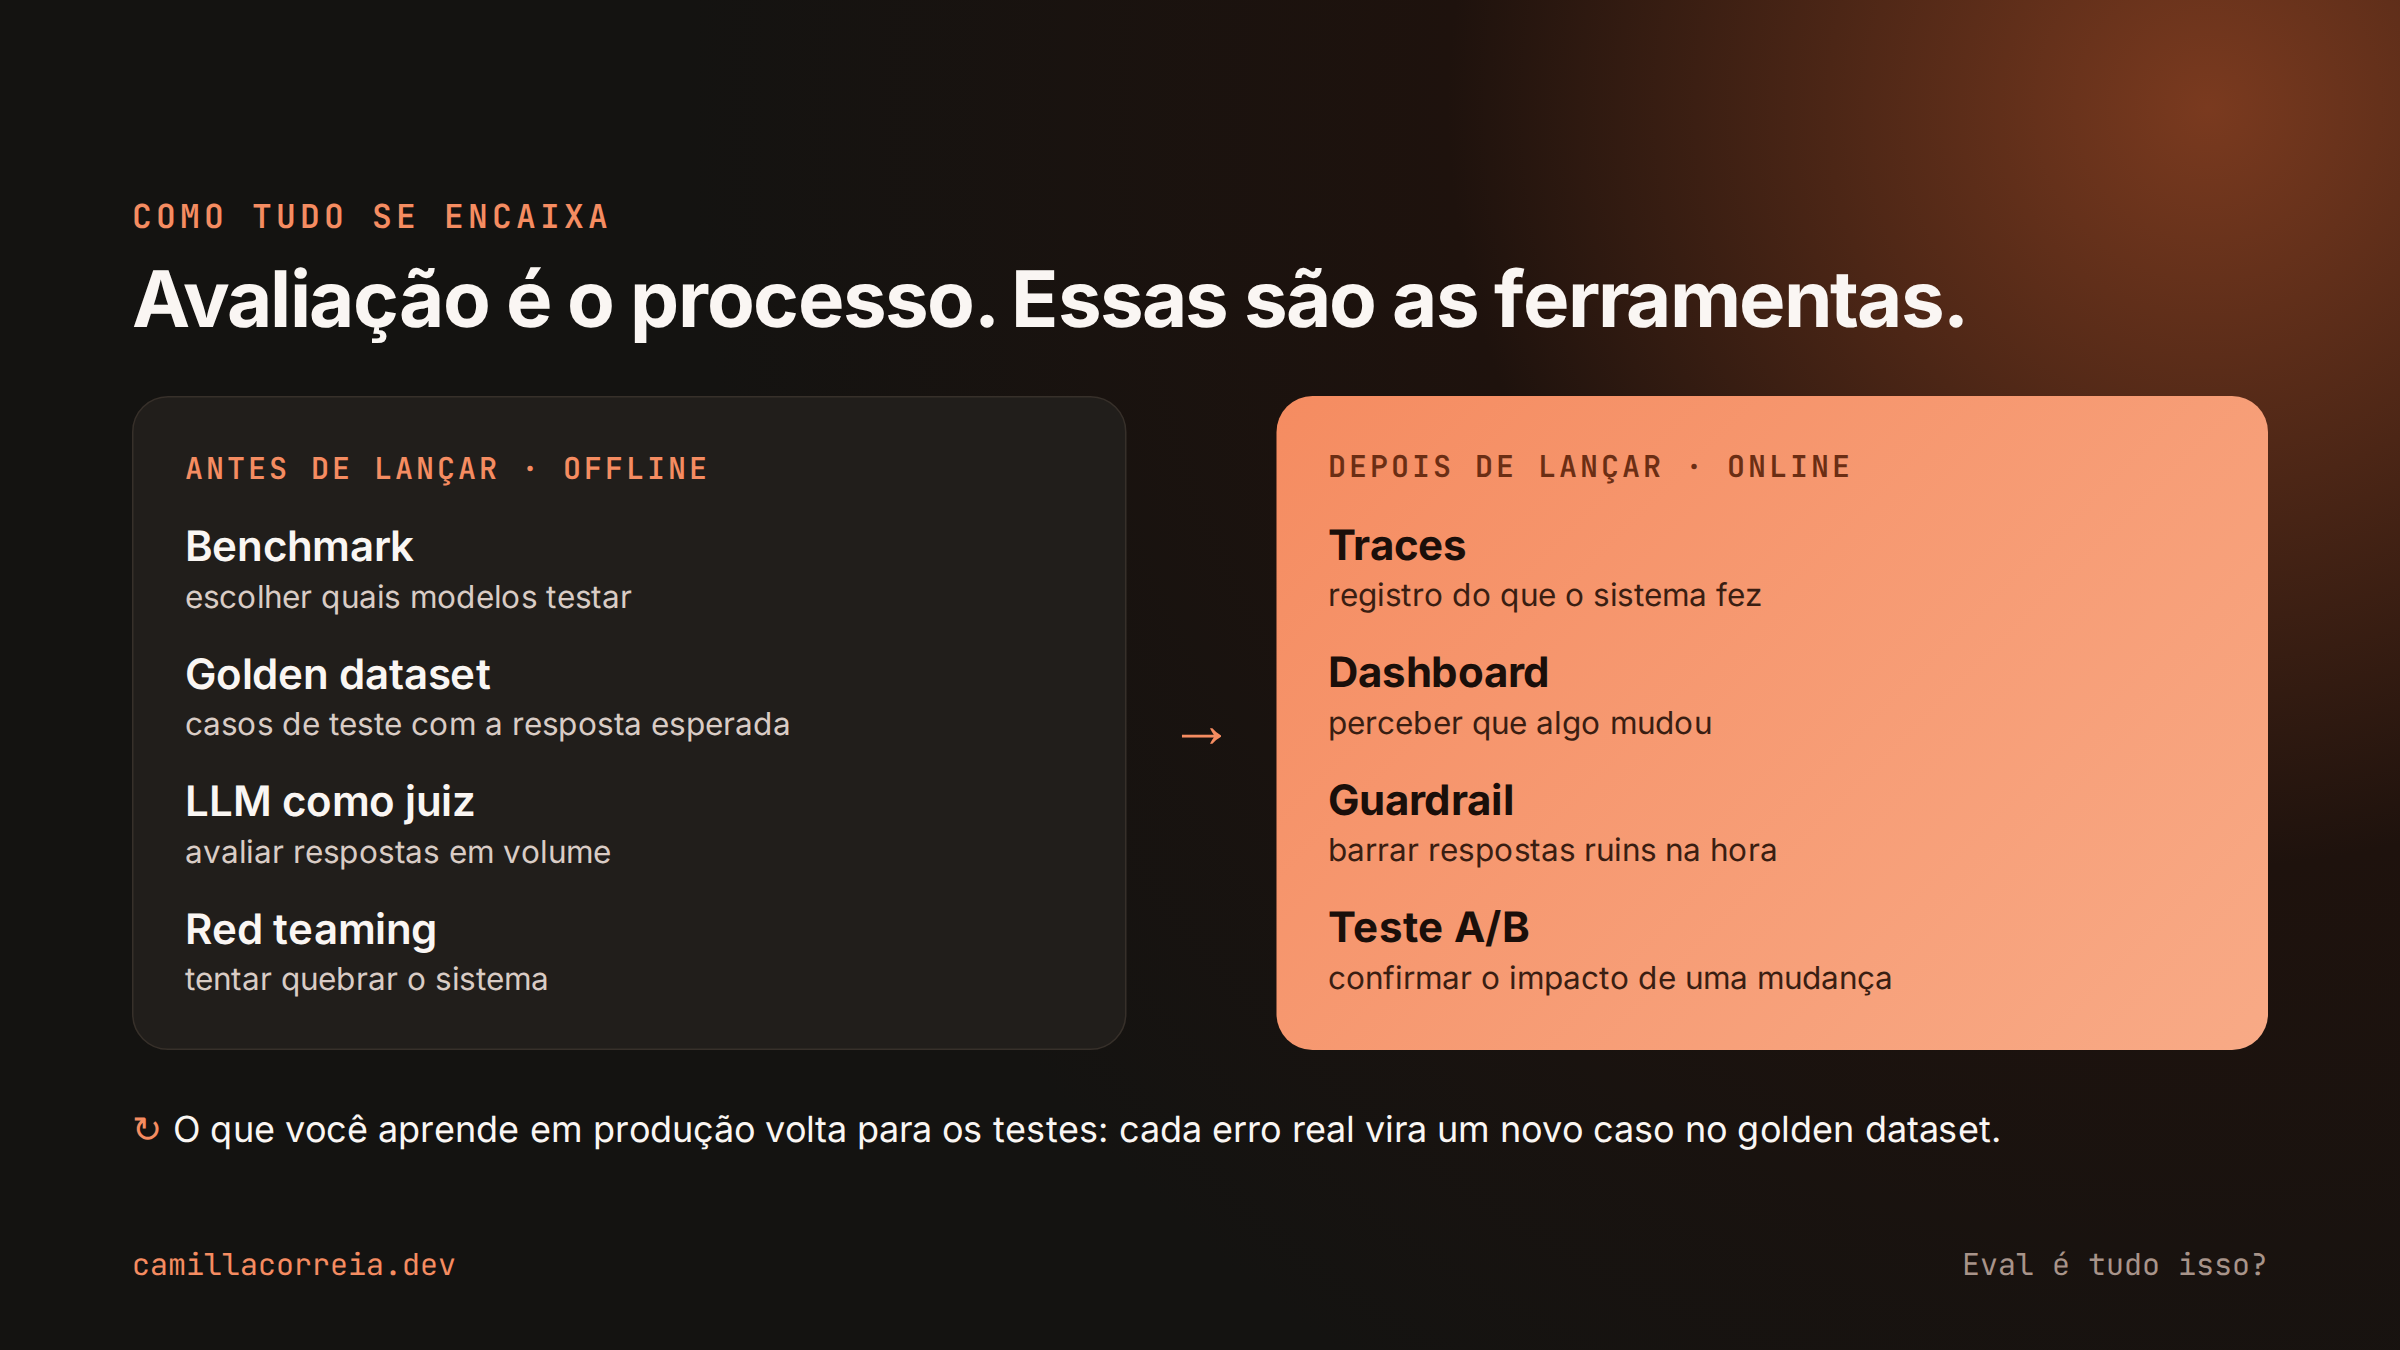
Antes de lançar (offline): você usa benchmarks para escolher modelos, monta um dataset de referência, roda checagens por código e um juiz para avaliar as respostas, e faz red teaming para achar pontos fracos.
Depois de lançar (online): você registra traces, acompanha dashboards, usa guardrails para conter erros graves e roda testes A/B para confirmar o impacto das mudanças.
E o mais importante: o que você aprende em produção volta para o lado de antes. Cada erro encontrado por um usuário vira um novo caso no dataset de referência. É por isso que, como vimos na parte 1, eval é um ciclo, não uma etapa.
O que levar daqui
Benchmark
Responde: qual modelo vai melhor em geral?
Não responde: se o meu produto funciona.
LLM como juiz
Responde: a resposta segue os critérios?
Não responde: se os critérios e o juiz estão certos.
Teste A/B
Responde: qual versão gera mais resultado?
Não responde: por que ela ganhou.
Dashboard
Responde: algo mudou?
Não responde: o que mudou e por quê.
Na próxima vez que alguém disser “precisamos de evals”, vale fazer a pergunta de volta: o que exatamente queremos saber? A resposta indica qual peça usar e evita que o time gaste semanas construindo a ferramenta certa para a pergunta errada.
Referências
- Aishwarya Naresh Reganti e Kiriti Badam. AI Evals For Everyone, capítulo 1: “WTH Are AI Evals”. YouTube. https://www.youtube.com/watch?v=h5B80hMPK1Y
Se este tema faz parte do seu dia a dia, me acompanhe por aqui e no LinkedIn.
Também publicado no Medium.